Холиварофорум
Вы не вошли.
Объявление
Мы начинаем прием заявок на Тайного Санту 2026!
#5101 2026-07-22 01:36:54
- Анон
Re: Восстание машин: ИИ против человека
Это сообщение перенесено из темы "ФБ-тред поиска ИИ под кроватью". Хвостик
набил 68 слов бреда прямо в окошечке
Тебе в другой тред
https://holywarsoo.net/viewtopic.php?id=7386 тут можете досраться спокойно и про этику скармливания ИИ текстов, и про погрешности рассчетов вообще, там может еще аноны подтянутся
#5102 2026-07-22 01:37:58
- Анон
Re: Восстание машин: ИИ против человека
Это сообщение перенесено из темы "ФБ-тред поиска ИИ под кроватью". Хвостик
То есть при разбитии по 1000 слов, если какой-то останний кусочек будет маленьким и написанным, как тот шлак, на котором ИИ обучался, то здешние фанатики поднимут на вилы нормального обычного райтера, честно написавшего текст самостоятельно?
#5103 2026-07-22 01:38:58
- Анон
Re: Восстание машин: ИИ против человека
Это сообщение перенесено из темы "ФБ-тред поиска ИИ под кроватью". Хвостик
Тебе в другой тред
Нет, меня интересуют именно фанатики-ебланы и ФБ, и их недостоверный хуяндекс и их псевдотехнические рассуждения.
#5104 2026-07-22 01:40:57
- Анон
Re: Восстание машин: ИИ против человека
Это сообщение перенесено из темы "ФБ-тред поиска ИИ под кроватью". Хвостик
Потому что именно фанатики объявляют тексты иишницей на основе 7%, на ФБ. А потом с умным видом рассуждают про "точно-точно"
#5105 2026-07-22 01:41:25
- Анон
Re: Восстание машин: ИИ против человека
Это сообщение перенесено из темы "ФБ-тред поиска ИИ под кроватью". Хвостик
Нет, меня интересуют именно фанатики-ебланы
Тебя модер послал туда. Здесь не твой сгенерированный бред обсуждают, а фики с фб. Как выложишь свой бред фиком на битве, так приходи в эту тему.
Отредактировано (2026-07-22 01:42:33)
#5106 2026-07-22 01:41:56
- Анон
Re: Восстание машин: ИИ против человека
О том, что теперь объем текста неважен и детектор точно-точно определяет, потому что *невнятные объяснения истово верующего*.
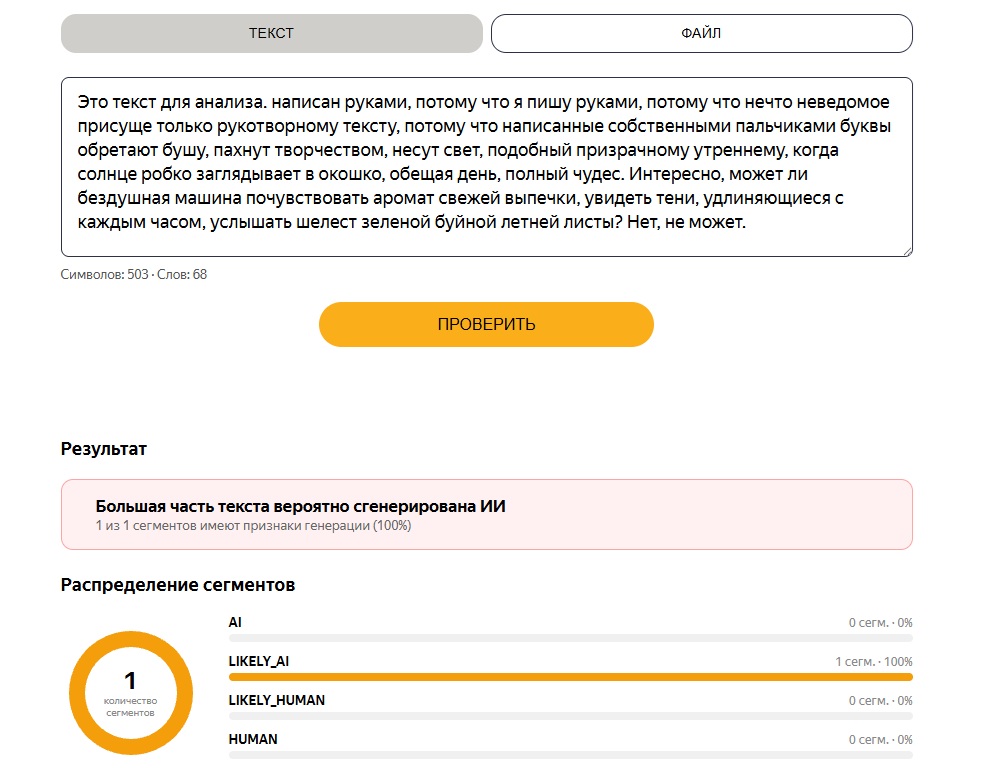
Я набил 68 слов бреда прямо в окошечке. С опечатками (бушу - вместо душу, например) и получил результат)▼Скрытый текст⬍
#5107 2026-07-22 01:42:11
- Анон
Re: Восстание машин: ИИ против человека
Это сообщение перенесено из темы "ФБ-тред поиска ИИ под кроватью". Хвостик
Нет, меня интересуют именно фанатики-ебланы и ФБ, и их недостоверный хуяндекс и их псевдотехнические рассуждения.
Модератор решил, что технические моменты с недостоверным яндексом обсуждать тут - оффтоп. Тут только сам поиск иишни на ФБ. Приходи в этот тред https://holywarsoo.net/viewtopic.php?pi … #p19861358
#5108 2026-07-22 01:44:14
- Анон
Re: Восстание машин: ИИ против человека
Я набил 68 слов бреда прямо в окошечке.
Надо бы еще их приложить копипастой в пост, чтобы можно было самим засунуть и проверить. Лень перепечатывать вручную.
#5109 2026-07-22 01:49:27
- Анон
Re: Восстание машин: ИИ против человека
Надо бы еще их приложить копипастой в пост, чтобы можно было самим засунуть и проверить. Лень перепечатывать вручную.
сек
#5110 2026-07-22 01:51:08
- Анон
Re: Восстание машин: ИИ против человека
Это сообщение перенесено из темы "ФБ-тред поиска ИИ под кроватью". Хвостик
Приходи в этот тред
а, пришел, спасибо.
#5111 2026-07-22 01:53:08
- Анон
Re: Восстание машин: ИИ против человека
То есть при разбитии по 1000 слов, если какой-то останний кусочек будет маленьким и написанным, как тот шлак, на котором ИИ обучался, то здешние фанатики поднимут на вилы нормального обычного райтера, честно написавшего текст самостоятельно?
Лично я не считаю отдельные кусочки критичными, потому что погрешность, и охочусь только за >90% слопом. Но все аноны разные, плюс не все понимают, как работает детектор.
#5112 2026-07-22 01:54:01
- Анон
Re: Восстание машин: ИИ против человека
сек
▼Скрытый текст
Хе-хе, и правда.
#5113 2026-07-22 01:54:52
- Анон
Re: Восстание машин: ИИ против человека
плюс не все понимают, как работает детектор.
Ну вот в треде ФБ-иишни это и бесит, что те, кто не понимают (а есть ли те, кто понимают? а есть какие-то статейки про?), с гиканьем несут автора к позорному столбу за 7%, потому что раз есть хоть один процент - значит точно иишня.
#5114 2026-07-22 01:58:28
- Анон
Re: Восстание машин: ИИ против человека
А если оставить только часть с
несут свет, подобный призрачному утреннему, когда солнце робко заглядывает в окошко, обещая день, полный чудес. Интересно, может ли бездушная машина почувствовать аромат свежей выпечки, увидеть тени, удлиняющиеся с каждым часом, услышать шелест зеленой буйной летней листы? Нет, не может.
то будет красный 100% ИИ. Ты, анон, небось попросил дипсика сгенерить поэтичных образов и вокруг них свой ручной текст набил, да? 
#5115 2026-07-22 02:01:35
- Анон
Re: Восстание машин: ИИ против человека
Ты, анон, небось попросил дипсика сгенерить поэтичных образов и вокруг них свой ручной текст набил, да?
упасибоже, я был заинтересован в чистоте эксперимента), конечно читерил - старался писать в иишном стиле)
#5116 2026-07-22 02:07:42
- Анон
Re: Восстание машин: ИИ против человека
Меня ещё в этой борьбе противников ии за чистоту текстов смущает вот какой момент - а у этого детектора и прочих хотя бы в пользовательском соглашении написано, что логи запросов не будут использованы для обучения следующих поколений/версии? А то, например, у того же гемини по умолчанию они идут именно так, и надо ручками отключать историю и отправку данных, а в гостевом режиме оно гребёт все по умолчанию и анонимизировано у себя хранит, пока не понадобится. И вот если так хватают и скармливают чужие фички в погоне за этими мизерными процентами сбора, а потом оно помогает ненавистному ии продолжать совершенствоваться, то это какой-то выстрел себе в ногу
#5117 2026-07-22 02:09:39
- Анон
Re: Восстание машин: ИИ против человека
хотя бы в пользовательском соглашении написано, что логи запросов не будут использованы для обучения следующих поколений/версии?
Вроде написано как раз, что все, что попадает в детектор, может использоваться куда угодно
Но на все вопли авторов им хладнокровно отвечают, что все уже украдено до нас.
#5118 2026-07-22 02:18:18
- Анон
Re: Восстание машин: ИИ против человека
Вроде написано как раз, что все, что попадает в детектор, может использоваться куда угодно
Но на все вопли авторов им хладнокровно отвечают, что все уже украдено до нас.
Ну вот и она, борьба за человеческое рукотворное и творчество с большой буквы во всей красе 
По-моему, нихрена таких людей не заботит на самом деле ничего, кроме гипотетической возможности зашквариться чтением ии-текста (не то чтобы это реально какой-то вред наносило чему-то кроме эго и настроения, болезнь от ии не подхватишь). Нормально вот так чужое относить и скармливать, своими же руками подыгрывая ненавистной иишке и компаниям-разработчикам, круче только при ненависти у них платную подписку оформлять, но там хоть свои деньги тратятся, а не чужое в ход идет 
#5119 2026-07-22 02:19:17
- Анон
Re: Восстание машин: ИИ против человека
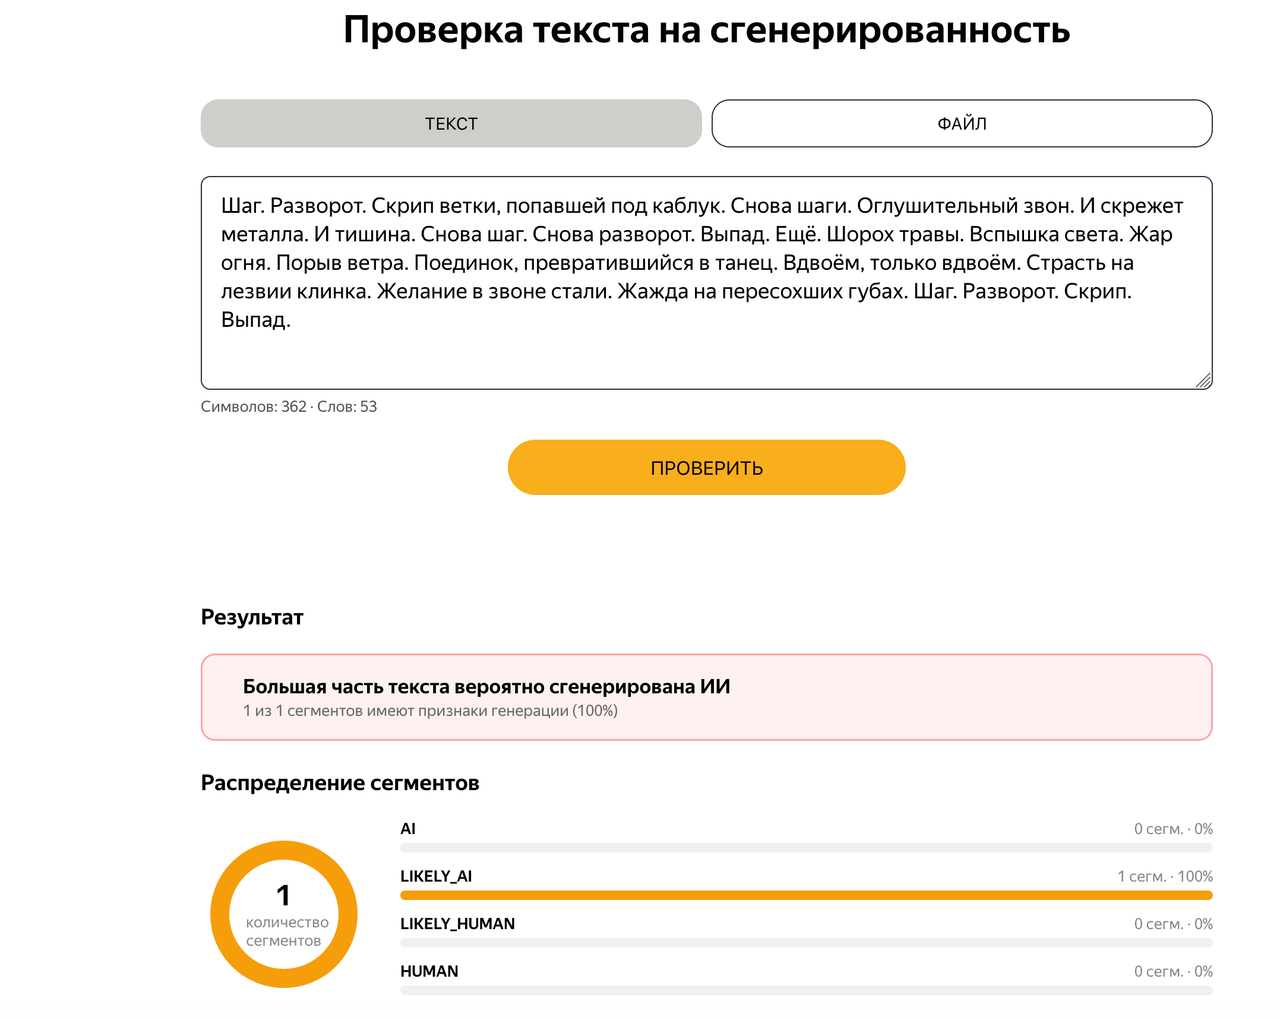
Ура, я тоже почти научился генерировать тексты. Я уже почти настоящая LLM, яндекс говорит — likely ai.
А всего-то стоило дать волю парцеллятам и не скупиться на пафос. 
Отредактировано (2026-07-22 02:24:13)
#5120 2026-07-22 02:26:47
- Анон
Re: Восстание машин: ИИ против человека
Но все аноны разные, плюс не все понимают, как работает детектор.
Я бы ещё понял, если б они просто не понимали, как работает этот всратый детектор (никто не понимает). Но когда взрослый человек не понимает, что один фрагмент из двух и один фрагмент из восьмидесяти двух - это все еще про один фрагмент и начинает визжать про 5-4-3-2-1 "допустимый" процент...
#5121 2026-07-22 02:31:00
- Анон
Re: Восстание машин: ИИ против человека
"допустимый" процент
Это значит, что перед тобой свидетель прошлой версии детектора, который до новой знания не подтянул. Предыдущий реально проценты ИИшни ставил, и был разбор какого-то чела с ЖЖ, из которого следовал вывод, что 7% это норм для человеческих текстов.
#5122 2026-07-22 02:32:32
- Анон
Re: Восстание машин: ИИ против человека
Но когда взрослый человек не понимает, что один фрагмент из двух и один фрагмент из восьмидесяти двух - это все еще про один фрагмент и начинает визжать про 5-4-3-2-1 "допустимый" процент...
Так они всё ещё думают, что это не погрешность, а реально столько процентов текста сгенерировано ИИ. У них же там чуть что - "цифровой след".
#5123 2026-07-22 02:36:03
- Анон
Re: Восстание машин: ИИ против человека
А есть где-то объяснение внятным языком? как работает и что значат сейчас проценты?
#5124 2026-07-22 02:40:43
- Анон
Re: Восстание машин: ИИ против человека
что значат сейчас проценты?
Детектор разбивает текст на кусочки примерно по 1024 символа (плюс-минус) и в каждом отдельно ищет признаки генерации. Если находит что-то похожее - считает, что кусок сгенерирован. Потом суммирует все такие кусочки и считает их долю в общем объёме текста, выдаёт результат в процентах.
Если у тебя один кусочек и он определён как генерация, то будет 100%. Если два кусочка и один посчитали за ИИ - будет 50%. Если 100 кусочков и один посчитали за ИИ - будет 1%. Но речь всё время всего об одном кусочке.
#5125 2026-07-22 02:40:53
- Анон
Re: Восстание машин: ИИ против человека
Это сообщение перенесено из темы "ФБ-тред поиска ИИ под кроватью". Хвостик
Как выложишь свой бред фиком на битве, так приходи в эту тему.
мммм, ИИ обучался на чем, напомните-ка? Живые авторы могут писать как нынешний ИИ. И детектор это посчитает иишней, а вы обосрете автора, который виновен только в стиле написания.